 By mariogarcia
El problema: una orden de compra que nunca llegaba a tiempo
Una orquestación en JD Edwards estaba pensada para cargar una orden de compra desde un archivo CSV. Nada raro en el requerimiento: leer el archivo, construir cabecera y líneas, llamar a P4310, listo. El problema apareció solo con datos reales — una orden de compra de 999 líneas.
Cada vez que alguien la ejecutaba pasaba lo mismo: el que llamaba se cansaba de esperar y reportaba un timeout. Solo que la orden de compra sí se había creado. Correctamente. Todas las veces. La orquestación no estaba rota — lo que estaba mal era cómo respondía.
Por qué el timeout no es realmente un bug
Una llamada HTTP síncrona hace una promesa: preguntas, esperas, recibes una respuesta en un tiempo razonable. Esa promesa funciona bien para una consulta, una actualización de un registro, una validación rápida. Se rompe en el momento en que el trabajo de fondo tarda minutos en vez de milisegundos — y construir una orden de compra línea por línea, 999 veces, validando cada una contra las reglas de negocio, es exactamente ese tipo de trabajo.
El instinto suele ser “hacerlo más rápido”: recortar validaciones, agrupar inserts, ajustar el SQL. A veces ayuda. Pero eso trata el síntoma. El desajuste real es de diseño: se le está pidiendo a un proceso largo que se comporte como uno corto, porque ese es el único modo en que se suelen construir las orquestaciones.
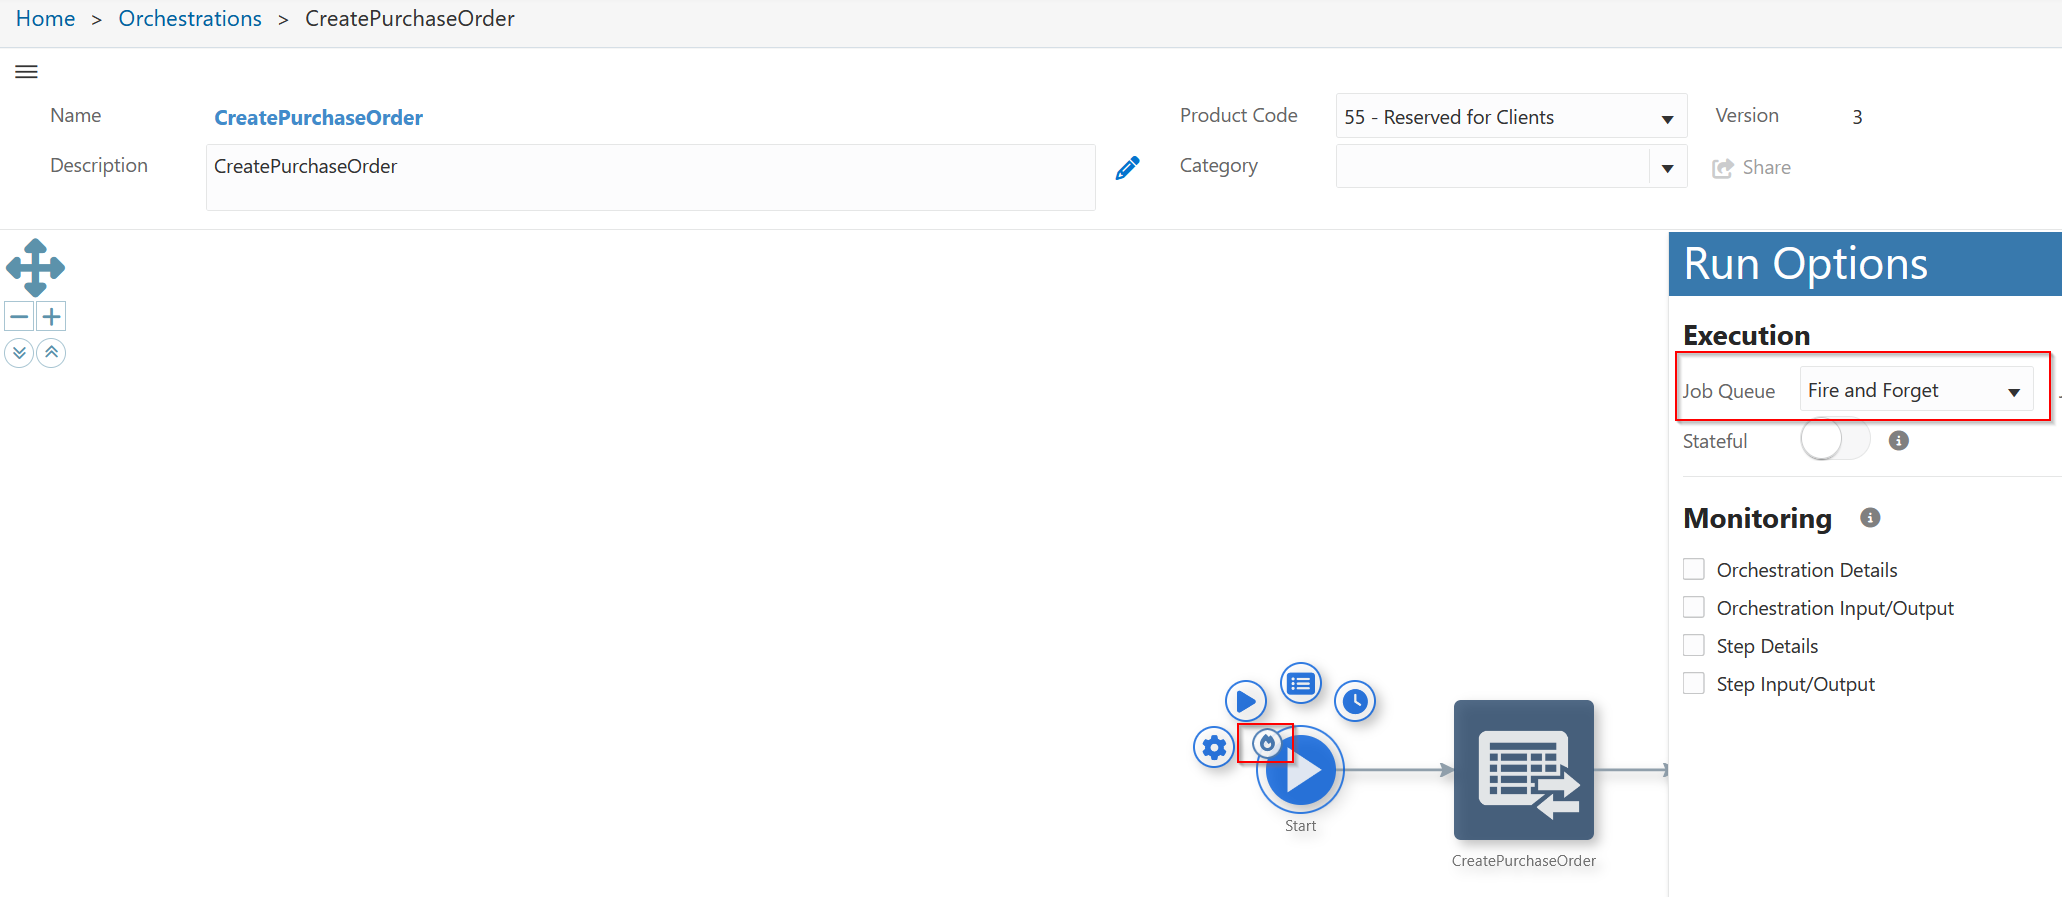
Qué hace realmente el modo Fire and Forget
JD Edwards Orchestrator tiene un modo de ejecución asíncrono que resuelve exactamente este desajuste, y se usa mucho menos de lo que debería: Fire and Forget.
En lugar de mantener la conexión HTTP abierta hasta que termine cada paso, la orquestación responde de inmediato con un HTTP 202 y un JSON vacío. El que llama recibe una respuesta en milisegundos — no “aquí tienes tu resultado”, sino “ya empecé, y no te voy a hacer esperar por el resto”.
El trabajo pesado — leer el CSV, construir cada línea de la orden de compra, validarla contra P4310 — sigue corriendo detrás, completamente separado de esa petición HTTP original. Ya nadie se queda mirando una conexión colgada.
El caso: 999 líneas, un CSV y un timeout que se repetía
Volviendo al caso original: pasar la orquestación a Fire and Forget no hizo que procesara las 999 líneas más rápido — sigue tardando más o menos lo mismo en validar y crear tantas líneas. Lo que cambió fue a quién le afecta esa duración.
Antes: el comprador sube el CSV, mira un indicador de carga y termina viendo un error — aunque por debajo JDE haya terminado el trabajo sin problema. Ahora: el comprador sube el CSV, recibe una confirmación instantánea de que el proceso arrancó, y sigue con lo suyo.
Construir la parte que realmente te avisa cuando termina
Fire and Forget por sí solo resuelve solo la mitad del problema. Un HTTP 202 te dice que el proceso arrancó — no dice nada sobre si terminó, ni si terminó bien. Esa segunda mitad hay que construirla.
La recomendación aquí es firme: si trabajas con Fire and Forget, cierra siempre el proceso con una notificación final que informe si hubo un error, o que confirme que el proceso ya terminó. Es la única forma de garantizar con certeza que el trabajo realmente se realizó — sin ese aviso, el 202 solo confirma que arrancó, nunca que terminó bien.
En la práctica, esa notificación final suele apoyarse en unas pocas piezas:
- Una segunda orquestación, o una comprobación programada, que busca la orden de compra cuando ya debería estar procesada y confirma que existe con el número de líneas esperado.
- Una notificación — correo, centro de mensajes de JDE, lo que tus usuarios realmente revisen — que se dispara cuando esa confirmación ocurre.
- Un camino de error: si la comprobación no encuentra lo esperado, la notificación lo dice explícitamente, en vez de dejar que el comprador asuma que todo salió bien porque nadie se quejó.
Nada de esto es exótico. Es la misma herramienta de notificaciones y monitoreo que ya existe en Orchestrator, apuntando a una pregunta distinta: no “¿la llamada tuvo éxito?”, sino “¿el trabajo realmente terminó?”.
Cuándo usarlo — y cuándo no
Fire and Forget encaja bien en un tipo concreto de problema: trabajo cuya duración no puedes acotar con precisión, donde el que llama no necesita el resultado dentro del mismo ciclo de la petición. Cargas masivas desde un archivo, iteraciones sobre grandes volúmenes de datos, cualquier cosa disparada por un lote de datos del usuario en vez de un solo registro.
No encaja en nada donde el que llama necesita una decisión inmediata — una validación de precio antes de confirmar una venta, una comprobación que bloquea la siguiente pantalla. Hacer eso asíncrono solo mueve la espera a otro sitio y añade complejidad que nadie pidió.
Detectar la necesidad antes de que se convierta en un incidente
El caso de la orden de compra solo se hizo visible porque alguien la probó con un archivo lo bastante grande. Las señales de alerta suelen aparecer antes, si sabes dónde mirar: orquestaciones cuyo tiempo medio de ejecución sube con el volumen de datos, integraciones donde el que llama es un script con su propio timeout que tú no controlas, o cualquier proceso donde en un ticket de soporte aparece “el registro se creó pero el que llamó reportó un error”. Cualquiera de esas señales merece revisar si la orquestación está haciendo trabajo de lote dentro de un presupuesto de tiempo pensado para una petición.
Una nota sobre idempotencia
Hay algo que Fire and Forget no resuelve por sí solo: si el que llama hace timeout, no recibe el 202 y simplemente reintenta el mismo archivo, puedes terminar con la misma orden de compra creada dos veces. Ese riesgo existe con o sin modo async — pero el modo async elimina la razón principal para reintentar a ciegas (la ilusión de que no pasó nada), así que es un buen momento para añadir también una comprobación de “¿esta petición ya se procesó?” antes de crear nada. Es un añadido pequeño, y cierra un hueco que es fácil pasar por alto hasta que aparece como una orden de compra duplicada en producción.
La lección de fondo
La orden de compra no era el problema. Tratar un proceso de varios minutos como si cupiera en una sola petición HTTP sí lo era. Fire and Forget no hace nada más rápido — hace que la orquestación sea honesta sobre cuánto tarda realmente, y mueve la pregunta de “¿ya terminó?” a donde debe estar: una comprobación separada y deliberada, en vez de una conexión que hace timeout en silencio.
Si tienes una orquestación que hace timeout con volúmenes reales, vale la pena preguntarse si necesita ser más rápida — o si simplemente necesita dejar de fingir que es instantánea.